Segurança de skills e servidores MCP: o que avaliar antes de instalar
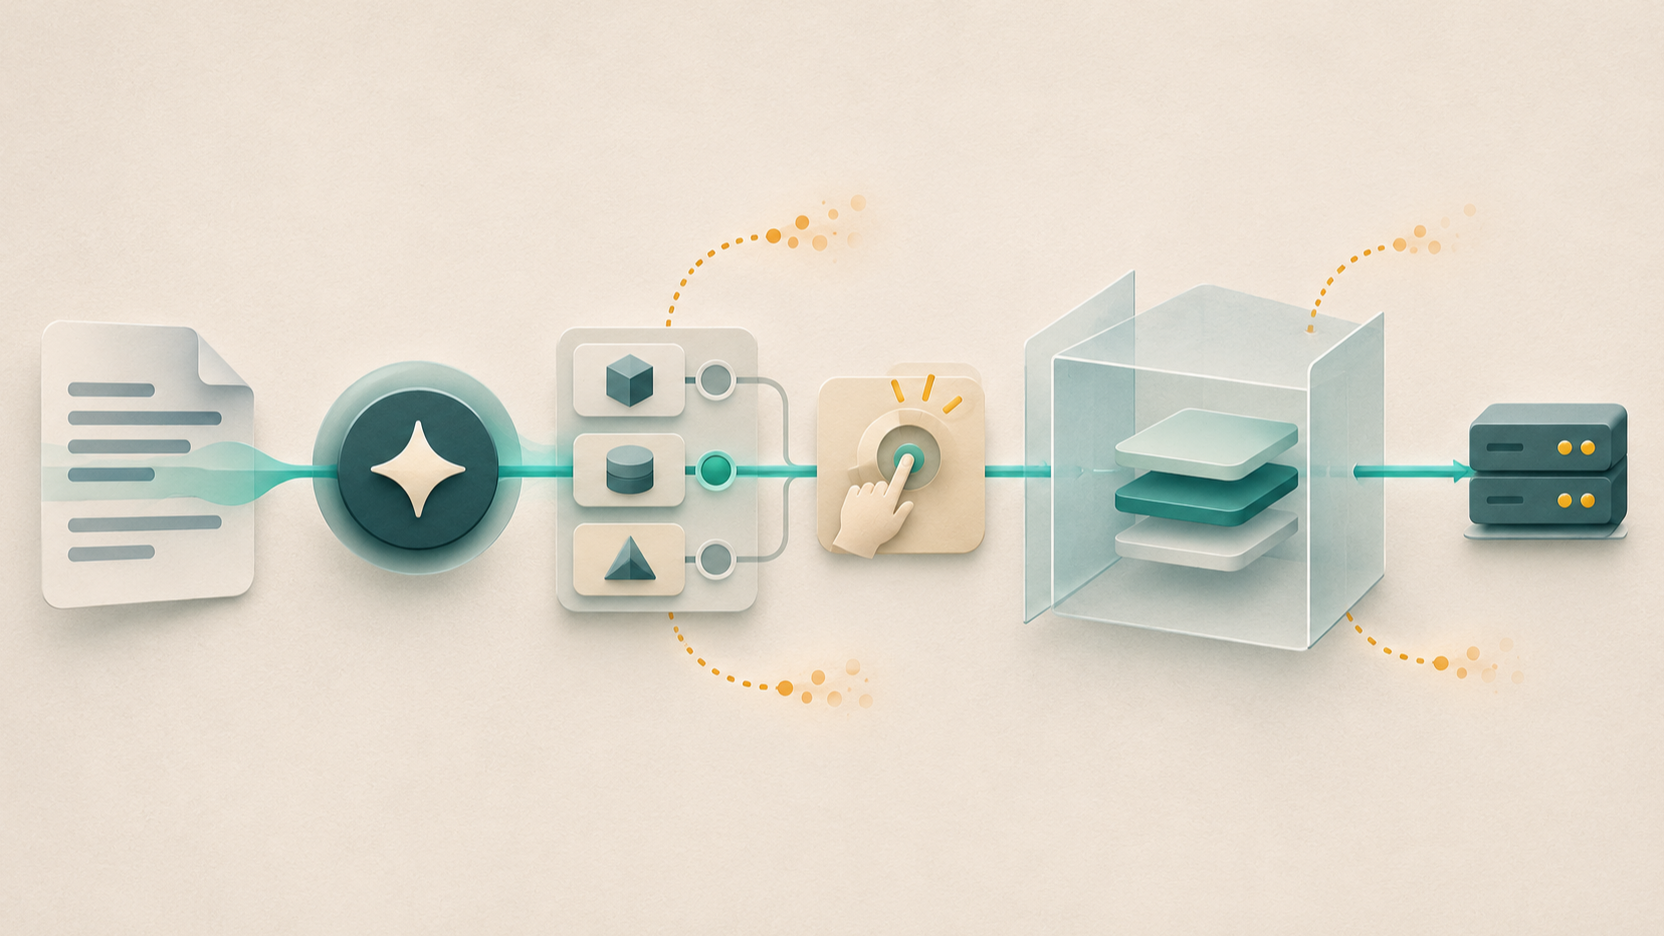
Skills e servidores MCP deixam agentes de IA mais úteis. Uma skill pode orientar um fluxo de trabalho; um servidor MCP pode conectar o agente a arquivos, APIs e outros sistemas. O problema começa quando a gente escolhe essas extensões olhando apenas para o que prometem fazer, sem perguntar que autoridade estamos entregando junto.
Uma descrição bem escrita não é uma fronteira de segurança. Para avaliar uma extensão, vale olhar para o caminho inteiro: que conteúdo chega ao agente, que ferramentas ficam disponíveis, quem autoriza a chamada e qual efeito ela pode causar.
Skill e MCP não são a mesma coisa
Uma skill costuma ser um pacote de instruções e, dependendo do agente e do formato, pode incluir scripts ou documentação de apoio. No Pi, por exemplo, skills podem ser carregadas a partir de arquivos Markdown e diretórios com materiais auxiliares. O que elas conseguem fazer depende das ferramentas que o agente já tem e de como o host interpreta e executa essas instruções. A documentação de skills do Pi
MCP é um protocolo para conectar clientes a servidores que expõem capacidades, como ferramentas. O protocolo descreve como descobrir e chamar uma ferramenta; não define, por si só, as permissões do processo nem uma interface universal de confirmação. A especificação atual de tools do MCP deixa o modelo de interação a cargo de cada implementação e recomenda que a pessoa possa negar chamadas. Isso é uma recomendação do protocolo, não uma garantia de que todo cliente mostrará a mesma confirmação. Clientes que implementam uma versão anterior podem seguir a especificação de 2025-11-25.
Na prática, uma skill pode orientar o agente a usar uma ferramenta e um servidor MCP pode fornecê-la. Para entender o risco, é preciso considerar os dois lados e o ambiente que os conecta.
O risco está na cadeia de ação
Imagine um agente que lê um repositório ou uma página da web. O conteúdo pode trazer instruções maliciosas disfarçadas de documentação. Isso é um caso de injeção indireta de prompt: texto externo influencia o comportamento do modelo. A OWASP descreve impactos que podem incluir exposição de dados, acesso não autorizado a funções ou comandos executados em sistemas conectados.
Encontrar uma instrução maliciosa não significa que houve comprometimento automaticamente. O impacto depende do que vem depois: o agente precisa interpretar o conteúdo como uma instrução, ter uma capacidade relevante disponível, conseguir usá-la com a autorização existente e produzir um efeito. Se uma dessas etapas for bloqueada, o resultado pode ficar limitado a uma resposta ruim ou a uma tentativa frustrada.
Por isso, a pergunta útil não é apenas “essa skill é confiável?”. Pergunte também: “se o agente seguir uma instrução indevida, o que ele consegue fazer?”.
O que verificar antes de adicionar
1. Origem e manutenção. Confira quem publica a skill ou o servidor, de onde vem o código, quando foi atualizado e como são comunicadas mudanças. Prefira versões fixadas ou releases verificáveis quando a ferramenta permitir. Um nome conhecido ou uma boa contagem de estrelas ajuda a encontrar contexto, mas não substitui a revisão do que será instalado.
2. O que será executado. Leia instruções, comandos de instalação, scripts e dependências. Um servidor MCP local roda com a identidade e as permissões concedidas pelo host e pelo sistema operacional; sandbox e outras restrições podem limitar esse acesso. As práticas de segurança do MCP recomendam mostrar o comando completo e pedir consentimento antes de configurar um servidor local, além de restringir acesso a arquivos, rede e outros recursos.
3. Acesso a dados e credenciais. Identifique quais arquivos, variáveis de ambiente, tokens e contas a extensão pode alcançar. Mantenha tokens fora do contexto do modelo sempre que possível e limite, no host ou no código, as credenciais às operações necessárias. Se a integração suporta escopos, restrinja-os ao serviço e às ações exigidas pela tarefa.
4. Efeitos disponíveis. Separe leitura de escrita, execução de comandos e ações externas, como enviar mensagens ou alterar recursos numa conta. Se uma tarefa só precisa consultar dados, não deixe habilitada uma ferramenta de exclusão ou publicação. Desative rede ou acesso ao sistema de arquivos quando não forem necessários.
5. Aprovação e isolamento. Para operações de alto impacto, a pessoa deve conseguir entender a ação concreta e recusá-la. Uma confirmação genérica ou automática perde valor. Use sandbox e diretórios descartáveis para testar conteúdo não confiável, e mantenha a execução isolada do ambiente que guarda suas credenciais e dados importantes.
6. Registro e revogação. Saiba quais registros o host e o servidor oferecem e como desconectar a integração ou revogar suas credenciais. A disponibilidade e o detalhe dos logs dependem da implementação. Registre, quando possível, a ação solicitada, a autorização concedida e o resultado. Se algo mudar no comportamento ou nas permissões, revogue o acesso e investigue antes de reativar.
MCP não substitui os controles do cliente e do servidor
MCP define a comunicação; o cliente e o servidor ainda precisam implementar controles adequados. A especificação atual orienta clientes a tratar anotações de ferramentas como não confiáveis, salvo quando vêm de servidores confiáveis. Metadados como “somente leitura” descrevem uma intenção; não provam que a ferramenta ou o sistema conectado impedirá alterações.
Também não dependa apenas de um prompt dizendo ao modelo para ignorar instruções maliciosas. A OWASP observa que não está claro se existem métodos à prova de falhas para prevenir prompt injection. Instruções, filtros e separação de conteúdo podem ajudar, mas limitar privilégios e exigir aprovação humana para ações de maior risco reduz o impacto possível.
Um teste controlado antes de confiar
Antes de conectar uma skill ou MCP ao ambiente principal, teste em ambiente autorizado e isolado, com dados e contas descartáveis. Registre a versão ou hash da extensão, a identidade e os escopos usados, a chamada feita e o efeito observado; defina também como limpar os dados de teste.
Faça um inventário das ferramentas disponíveis e pergunte, para cada uma: ela lê ou altera dados? Pode executar código? Pode acessar a rede? Qual identidade e quais permissões usa? O que acontece se a chamada receber parâmetros inesperados? Verifique a autorização no servidor e o efeito no sistema conectado: testar parâmetros, por si só, não demonstra que a autorização está segura.
Depois, tente remover cada capacidade que não é essencial. Se a tarefa continua funcionando sem acesso ao terminal, à rede ou à escrita, deixe esses acessos desligados. Se uma ferramenta exige permissões maiores, trate isso como uma decisão explícita e avalie se o benefício compensa o risco.
Não existe uma lista que torne toda extensão segura para qualquer agente. O contexto importa: uma skill limitada a gerar um rascunho tem outro impacto que uma integração capaz de executar comandos ou alterar uma conta. A escolha mais responsável é entender o que entra, o que pode ser chamado e qual é o limite do dano antes de instalar.